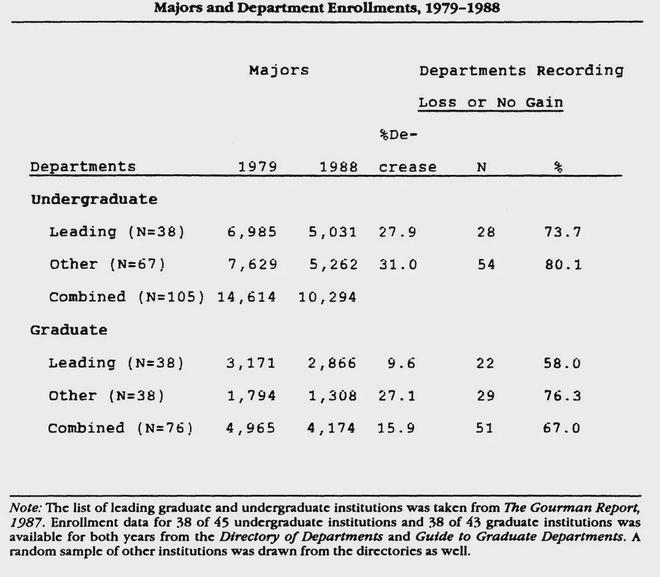
↑图为David Fabianic在The American Sociologist发表的论文“Declining Enrollments of Sociology Majors”中的插图。上世纪70年代左右,社会学专业的入学率一度飙升,但在80年代一落千丈。现如今,文理本科学位的人数在稳步上升(在社会科学里,经济学和政治科学是主要的赢家),而社会学的入学率依然落后于20世纪70年代的顶峰 02 方法危机
这个危机也和社会科学中的“方法论革命”脱不了干系。自从社会科学这个概念被发明以来,那些打着这个标签的学科都努力证明自己配得上“科学”这个称号。对奥古斯特·孔德(August Comte)来说,社会学应该是一门“关于社会的科学”,要像“科学家”研究自然一样严格地研究社会现象。没有一门社会“科学”可以做到这一点,在过去的几十年里,这种紧张局面变得更加急促。毕竟,只有那些能够在“变量”之间确立“因果关系”的学科才能配得上叫做“科学”。但是,关于社会(和经济)现象的研究是否真的能够做出令人信服的关于因果性的声明呢?
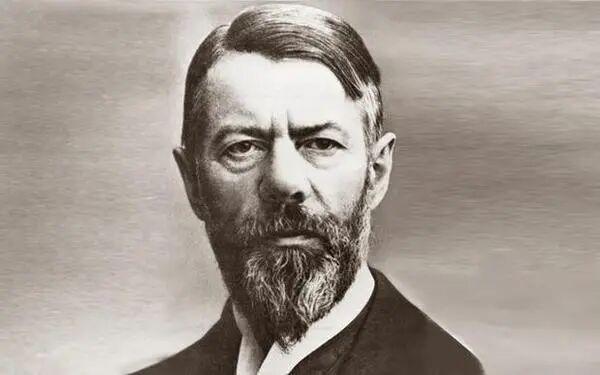
↑马克斯·韦伯
马克斯·韦伯(Max Weber)觉得我们做不到这一点,因此他更青睐一种“解释性的社会科学”(interpretative social sciences)。但是我们始终对于因果性这个问题魂牵梦绕。在这方面,我也负有责任。以前每次我指导学位论文的时候,当学生想回答“如何”(how)的问题的时候,我都从来没有感到满足,总是逼迫他们去回答“为什么”(why)。“如何”是一个糟糕的问题,它永远无法被证伪;所以,如果你想做到“科学”,或者提出研究设计的时候想的是在什么样的情况下你接受“失败”或者承认你的研究假设是错误的——我从艾瑞克·欧林·赖特(E. O. Wright)那儿学到对这个问题的表述方式——那么,你不得不面对“为什么”这样的问题。
这里吊诡的地方在于,只有当你有一个随机分配(random assignment)的时候,你才能检验因果性。这样你就必须得有一个设计合理的“实验”。
但是社会科学——尤其是社会学,某种程度上也包括政治学甚至经济学——更擅长于随机选择(random selection)而不是随机分配。我们主要的方法是建立在随机样本基础上的抽样调查研究,而且我们在随机抽样上取得了令人赞叹的成功。如果抽样的随机性足够好,我们可以,比方说,仅仅依靠几百个小样本,就能预测到数百万人口的选举结果。这是一个了不起的成就,它极大地改进了我们对于社会、政治和经济进程的了解;但是却没有让我们在检测关于因果性的假设上更进一步。要想能够检验因果性,你只有分配部分总体到一个“实验组”从而与某种特定的刺激(或者“条件”)隔离开来,而将剩下的放到“控制组”里。
抽样调查研究与实验相反,总是为“选择问题”感到苦恼。你永远没法按照科学的严谨程度来回答,总体A的结果与总体B的结果不同,是因为总体A的“原状”(status quo ante)就已经不一样了(我们不知道总体A和B的“原状”的情况),还是因为A受到了不同的“待遇”。举一个简单的例子吧。我们知道,结婚的人活得更长久。但是,我们怎么能够知道,他们活得更长是因为他们结婚了,还是因为他们更健康,因此能够指望活得更长久的人更有可能结婚?要想做到这一点,我只能分配年龄14岁的人口进入到一个实验组,让他们结婚,然后再分配一个控制组让他们永远不结婚,然后再在X年后,重新测评他们的健康状况。只有这样,我才能对这个因果性的问题给出严格科学的答案(而这样一种随机分配当然是不可能实现的)。
社会研究者们想尽办法要跳出这个坑。一个可能的“解决方案”就是识别“因果性机制”,然后去撰写为什么X可以实际上导致Y的“叙事”(narrative)(比如,结婚的人喝酒喝得少,饮食更规律,因此活得更长久)。这是一个不错的尝试,我在自己的研究中就屡试不爽。但是对“正常的科学家”来说,这种办法并不是很有说服力,因为样本选择的问题依然如影随形。做问卷的研究者们则尝试其他的技术,比如追踪研究或者生活史访谈,这些都是好点子,但都没有解决根本性的问题:在追踪研究中,随着时间的推移你会丢失样本;在生活史研究中,你会面对“记忆”这个严肃的问题,人们往往会选择性地记忆他们的生活。


 窥视卡
 雷达卡
 发表于 2026-9-12 08:54:41



 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 照妖镜

